
네이버 검색은 콘텐츠를 어떻게 평가하는가
네이버 검색은 검색 의도에 따라 결과 영역을 구성하고 각 영역에서 서로 다른 랭킹 모델로 콘텐츠를 평가한다. 출처를 중심으로 보는 C-Rank와 개별 문서를 평가하는 D.I.A.의 차이부터 스마트블록, AI 브리핑까지 네이버가 공개한 검색 원리를 살펴본다.


검색 의도에 따라 결과 영역 달라지고 문서·출처 특성 함께 평가
C-Rank는 출처, D.I.A.는 개별 문서 평가하는 대표 모델
네이버 검색은 하나의 고정된 기준으로 모든 콘텐츠의 순위를 정하지 않는다. 네이버가 공개한 검색 노출 기준에 따르면 검색결과에는 검색 영역별로 서로 다른 랭킹 모델이 적용되며, 어떤 검색 영역을 먼저 보여줄지 결정하는 검색 영역 간 랭킹도 함께 작동한다.
블로그 검색에서도 C-Rank와 D.I.A.를 비롯한 다수의 모델과 스팸·유사 문서 분석 로직 등이 적용된다. 따라서 네이버 검색을 이해하려면 특정 알고리즘 하나보다 검색 의도에 따라 결과가 어떻게 구성되고, 그 안에서 출처와 개별 콘텐츠가 어떤 관점에서 평가되는지를 함께 살펴볼 필요가 있다.
검색어에 따라 검색결과 구성이 달라진다
네이버 통합검색에는 블로그와 카페, 웹문서, 이미지, 동영상 등 여러 유형의 검색결과가 존재한다. 모든 검색어에서 이들 영역이 같은 순서로 나타나는 것은 아니다.
네이버는 검색 영역별 특성에 따라 각각 다른 랭킹 모델을 적용하고, 검색 영역 간에도 별도의 랭킹을 적용한다고 설명한다. 이용자의 검색 행동을 분석해 원하는 정보가 있을 가능성이 높은 검색 영역을 먼저 보여주며, 이에 따라 검색결과의 구성과 순서가 달라질 수 있다.
개별 문서의 순위만으로 네이버 검색 전체를 설명하기 어려운 이유다. 어떤 종류의 결과가 검색어와 이용자의 요구에 적합한지를 판단하고, 각각의 검색 영역 안에서는 다시 적합한 콘텐츠를 가려내는 과정이 필요하다.
스마트블록은 검색 의도에 따라 콘텐츠를 구성한다
검색어가 같거나 비슷해도 이용자가 원하는 정보는 하나가 아닐 수 있다. 정보나 실제 경험·후기, 상품, 장소, 동영상 등 다양한 형태의 결과를 찾을 수 있다.
네이버는 2024년 기존 VIEW 영역을 ‘인기글’ 스마트블록으로 전환하면서 이용자의 검색 의도를 세분화해 주제에 따른 콘텐츠를 제공한다고 설명했다. 블로그와 카페 등 이용자 생성 콘텐츠를 단순히 나열하기보다 검색 의도와 관련된 경험·의견·리뷰 등을 주제별로 제공하는 방식이다.
스마트블록은 콘텐츠 품질을 평가하는 하나의 랭킹 알고리즘이라기보다 검색 의도를 바탕으로 관련 콘텐츠를 주제별로 구성해 보여주는 검색결과 방식으로 구분할 수 있다.
관련콘텐츠
⟶ 네이버 검색 알고리즘 ‘멀티미디어·UX 중심’ 평가 구조로 전환
네이버는 검색 콘텐츠의 무엇을 평가하나
검색결과의 영역과 형태를 구성하는 것과 그 안에서 어떤 문서를 보여줄지를 평가하는 것은 구분해서 볼 필요가 있다.
네이버가 공개한 일반적인 검색 노출 기준에서는 적합도를 판단하는 대표적인 요소로 검색어와 문서의 유사성, 문서 자체의 품질, 이용자 선호도를 제시한다. 블로그 검색에서는 문서 속성과 출처의 특성, 전문성 등을 자동 분석하는 여러 모델도 함께 활용된다.
C-Rank와 D.I.A.는 이를 이해하는 대표적인 모델이다. C-Rank는 출처를, D.I.A.는 개별 문서를 중심으로 평가하며 네이버는 두 모델이 상호 보완적으로 검색 랭킹에 활용된다고 설명한다.
| 구분 | C-Rank | D.I.A. |
|---|---|---|
| 주요 평가 관점 | 출처 | 개별 문서 |
| 핵심 역할 | 주제별 출처의 신뢰도·인기도 평가 | 문서의 경험·정보성 등 평가 |
| 의미 | 누가, 어떤 출처에서 정보를 제공하는가 | 해당 문서가 검색 이용자에게 얼마나 적합하고 유용한가 |
C-Rank는 콘텐츠가 나온 출처를 본다
C-Rank는 개별 문서 자체보다 해당 문서가 나온 출처의 신뢰도를 평가하는 알고리즘이다.
네이버는 C-Rank가 블로그의 관심사 집중도(Context), 정보의 품질(Content), 콘텐츠 소비와 생산의 연쇄반응(Chain) 등을 종합적으로 판단해 해당 출처의 신뢰도와 인기도를 계산한다고 설명한다.
특정 문서 한 편만 평가하는 것이 아니라 어떤 주제를 다뤄온 출처인지, 해당 분야에서 어떤 콘텐츠를 생산해왔는지 등 출처에 축적된 특성을 함께 보는 방식이다.
C-Rank를 흔히 말하는 ‘블로그 지수’와 동일하게 이해해서는 안 된다. 네이버는 ‘저품질 블로그’, ‘최적화 블로그’, ‘블로그 지수’ 등이 네이버가 만든 개념이 아니라고 명시하고 있다.

관련콘텐츠
⟶ 네이버 C랭크란 무엇인가… 블로그 검색 로직과 D.I.A 차이
D.I.A.는 개별 문서의 경험과 정보성을 평가한다
D.I.A.(Deep Intent Analysis)는 개별 문서 자체의 경험과 정보성을 분석해 랭킹에 반영하는 모델이다.
네이버는 문서의 주제 적합도와 경험 정보, 정보 충실성, 문서 의도, 독창성, 적시성 등 여러 요소가 복합적으로 반영된다고 설명한다.
따라서 출처의 신뢰도가 높다는 사실만으로 모든 문서의 높은 순위가 보장되는 것도 아니며, 개별 문서만 잘 작성했다고 검색 순위가 정해지는 것도 아니다. 네이버는 다양한 문서 속성과 출처 특성, 전문성 등을 분석하는 모델을 함께 활용한다고 밝히고 있다.

관련콘텐츠
⟶ 네이버 D.I.A.란 무엇인가… 공식 평가 요소와 C랭크 차이
C-Rank와 D.I.A.만으로 네이버 검색을 설명할 수는 없다
C-Rank와 D.I.A.는 네이버 검색을 이해하는 대표적인 모델이지만 두 모델만으로 전체 검색 알고리즘을 설명할 수는 없다.
네이버 블로그 검색에는 C-Rank와 D.I.A.를 포함한 다수의 모델이 적용되고 있으며, 변질·스팸·유사 문서를 분석하는 로직도 함께 활용된다. 일반 검색에서는 검색 영역별 랭킹과 검색 영역 간 랭킹이 존재하고 검색어와 문서의 관련성, 문서 품질, 이용자 선호 등도 고려된다.
따라서 ‘C-Rank 점수가 높으면 상위 노출된다’거나 ‘D.I.A. 기준을 충족하면 상위에 올라간다’는 식의 공식으로 단순화하기 어렵다. 검색결과는 여러 모델과 신호를 바탕으로 자동 생성되며 순위도 고정돼 있지 않다.
관련콘텐츠
⟶ 네이버 로직이란?… 검색 결과 순위를 정하는 알고리즘
AI 브리핑도 검색 의도에 맞춰 정보를 제공한다
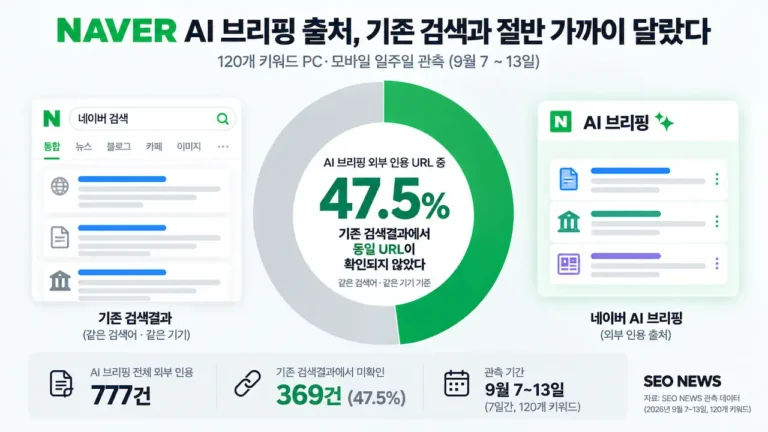
네이버는 2025년 통합검색에 AI 브리핑을 도입했다. AI 브리핑은 생성형 AI를 활용해 검색결과의 핵심 정보를 정리하고 출처를 연결하며, 검색 의도를 분석해 질의에 맞는 형태로 정보를 제공한다.
AI 브리핑 역시 C-Rank나 D.I.A.와 같은 콘텐츠 평가 알고리즘이라기보다 검색 이용자가 정보를 탐색하는 검색결과 경험으로 구분하는 편이 적절하다. 네이버는 이후 AI 브리핑을 정보 검색뿐 아니라 쇼핑·로컬·금융 등으로 확장하고, AI 검색을 위한 검색 LLM과 콘텐츠 투자를 확대하는 방향도 공개했다.
네이버가 공개한 여러 설명을 하나의 내부 알고리즘 처리 순서로 연결해서는 안 된다. 검색 순위를 결정하는 상세한 내부 로직 전체가 공개된 것은 아니기 때문이다. 공개된 범위에서는 검색 의도에 따라 검색결과 영역과 콘텐츠가 구성되고, 각 영역에서 검색어와의 관련성, 문서 품질, 이용자 선호, 출처와 문서 특성 등을 여러 모델이 평가하는 구조로 이해할 수 있다.
관련콘텐츠
⟶ 같은 키워드인데 날짜마다 AI 브리핑 출처가 바뀌는 이유